
昇思MindSpore 2.11版本正式发布,使能昇腾950代际高效MXFP8低精训练
经过昇思MindSpore开源社区开发者们几个月的开发与贡献,现正式发布昇思MindSpore2.11版本。 超节点亲和并行MindSpore HyperParallel,支持面向昇腾950的MXFP8低精训练加速前后向计算,发布Multicore多核并行框架实现整网续训提速26.9%,同时支持Hugging Face模型快速接入,并通过FSDP参数非均匀切分简化模型适配与断点续训。 昇腾亲和图模式MindSpore DVM,支持VF融合提升DVM融合算子性能。 在基础框架演进方面,新增支持MXFP8低精算子,大尺寸矩阵计算性能最高提升54%。 下面就为大家详细解读昇思MindSpore 2.11版本的关键特性。
——超节点亲和并行MindSpore HyperParallel——
1 面向昇腾950的MXFP8低精训练,按需接入,加速前后向计算
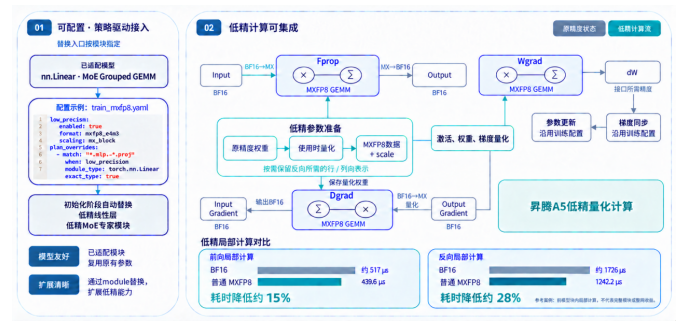
随着大模型规模增长,线性层与MoE专家模块中的矩阵计算成为训练的重要开销。昇腾950的低精计算能力为提升训练效率提供了硬件支撑,而模型接入、前后向适配和量化数据管理仍需要框架协同。HyperParallel面向昇腾950,将MXFP8低精能力封装为可配置的计算模块,支持按需替换目标模块,让用户逐步引入低精训练。
1.1配置驱动,按模块接入
可通过配置选择目标模块和低精策略,框架在模型构建阶段完成相应替换,未选中的模块沿用原有计算路径。对于Linear,替换过程复用原有权重和偏置参数对象,避免重新分配一份完整权重,减少逐层修改模型代码的工作。除通用Linear外,框架还支持通过专家模块适配,将低精计算能力用于MoE分组矩阵乘。
1.2软硬协同,覆盖前后向训练计算
MXFP8按32个元素分块管理缩放信息,将所需的输入、权重和输出梯度转换为低精表示。前向计算、输入梯度计算与权重梯度计算,通过统一的算子适配层调用昇腾950支持的低精矩阵计算能力,输出和梯度按接口所需精度返回,参数更新沿用训练配置。用户可以围绕目标模块引入低精计算,同时保留其他模块的精度策略。
1.3按需保留,减少冗余数据驻留
框架结合反向计算需求管理行向、列向量化数据及其缩放信息,仅保留后续计算需要的表示,释放不再使用的方向。通过统一的量化与算子适配层,降低模型适配与量化数据生命周期管理的复杂度。
1.4低精实测,前后向均获益
在Atlas 950 SuperPoD单机环境替换MoE模块进行高低精对比实验。普通MXFP8较高精BF16在前向、反向耗时分别降低约15%和28%。实验采用seq_length=4096、输入/输出维度2048、中间维度9216,实验结果显示在单个MoE模块内的高低精性能有明显提升。
2 发布Multicore多核并行框架,支持MegaMoE等融合内核,整网续训提速26.9%
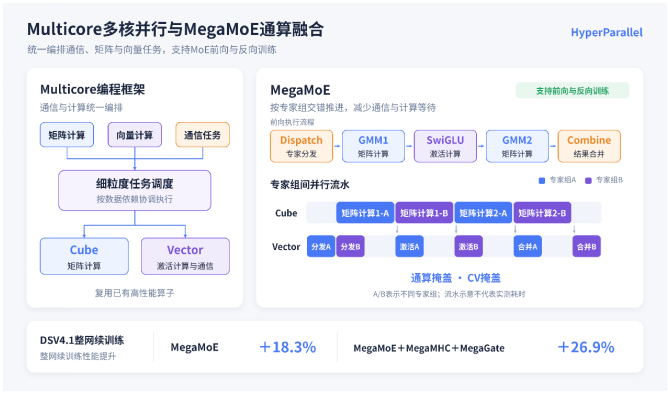
随着大模型结构日趋复杂,通信与计算交织带来的执行等待制约了训练效率,而跨算子融合又需要处理复杂的核间调度与同步,增加了开发和适配成本。为此,HyperParallel发布面向昇腾的Multicore多核并行编程框架,将通信、矩阵计算与向量计算纳入统一任务图,按数据依赖进行细粒度调度。开发者可复用已有高性能算子,减少底层调度与同步逻辑的重复开发,更高效地构建和适配MegaKernel,在降低开发成本的同时,充分发挥Cube与Vector的并行能力。 基于Multicore针对MoE通算掩盖不足的问题设计了MegaMoE,将专家分发、矩阵计算、激活与结果合并纳入统一流水,支持完整前向与反向训练。通过专家组间交错执行,MegaMoE同时提高通信与计算、Cube与Vector的重叠程度,减少设备等待,提升整网续训练效率。 在昇腾Atlas 800 A3超节点的64卡测试环境中,MegaMoE在DSV4.1续训练中实现MoE模块50.1%的性能提升,和整网18.3%的性能提升;同时开启MegaMoE、MegaMHC和MegaGate后,整网续训性能提升达26.9%。
参考链接:https://github.com/mindspore-ai/hyper-parallel/blob/master/hyper_parallel/core/multicore/README.md
3 实现Hugging Face模型快速接入,训练策略灵活配置
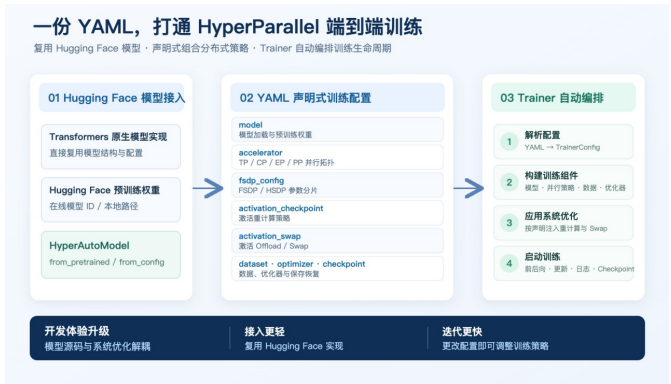
随着Hugging Face模型不断更新,模型结构和预训练权重越来越容易获取,但将新模型用于集群训练,仍需完成并行策略配置、显存优化、数据接入和断点恢复等工作。 HyperParallel面向Hugging Face生态提供端到端训练能力,复用已有的模型结构与计算实现,并通过适配层按需注入算子替换、并行切分和重计算等能力,让模型实现与分布式训练策略解耦。 用户在YAML配置文件中指定模型、数据、优化器和并行策略,HyperParallel据此构建训练组件并启动任务。对于已适配模型,开发者可以根据计算资源调整TP、CP、EP、FSDP和激活重计算等设置,无需反复修改模型主体代码;损失、吞吐、显存和检查点则帮助判断训练状态。模型代码与训练策略的解耦,使训练方案更易在不同环境中迁移和调优。 基于统一的模型接入机制,HyperParallel已适配Kimi、DeepSeek等模型,复用已有的并行、显存优化和训练组件,推动新模型快速接入。 在昇腾Atlas 800 A3超节点上进行的Qwen3-30B-A3B训练对比中,两套方案采用相同配置,损失收敛趋势一致;采用HyperParallel-FSDP2+Muon时,训练吞吐较PyTorch-FSDP2+Muon提升幅度超过200%。
参考链接:https://github.com/mindspore-ai/hyper-parallel/tree/master/examples/training_demo
4 FSDP支持参数非均匀切分,简化模型接入与断点续训
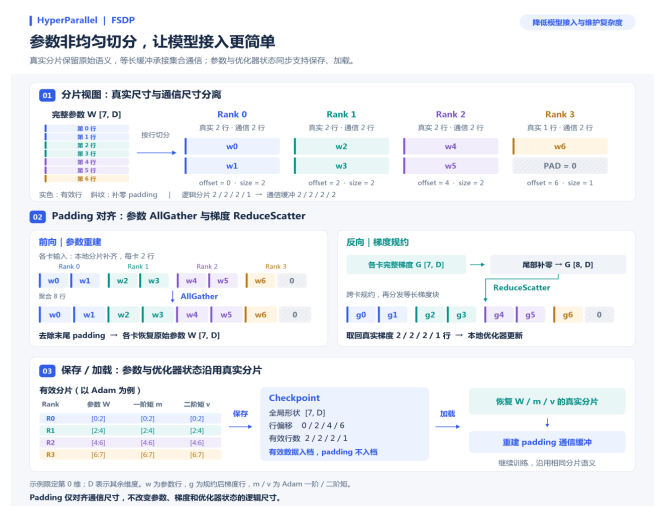
FSDP新增参数非均匀切分能力:当参数第0维无法被分片数整除时,框架自动处理各卡分片长度差异。用户无需为满足整除约束修改模型结构,或手写补齐、裁剪及通信适配代码,可沿用现有FSDP接入方式,降低模型迁移与维护复杂度。
4.1通信自动补齐,计算保持原形
框架按统一长度构造padding缓冲,AllGather聚合等长分片后去除补齐区域,恢复原始参数;反向将梯度补零对齐后执行ReduceScatter,再取出各卡有效梯度用于优化器更新。例如,7行参数分至4卡,真实分片为2、2、2、1行,通信按每卡2行对齐。
4.2Distributed Checkpoint(DCP)适配
支持非均匀切分参数及优化器状态的保存与加载,按全局形状、分片偏移和真实尺寸记录与恢复有效数据;加载后重建通信缓冲,减少断点续训的适配工作。
参考链接:https://gitcode.com/mindspore/hyper-parallel
——昇腾亲和图模式MindSpore DVM——
5 支持VF融合,提升DVM融合算子性能
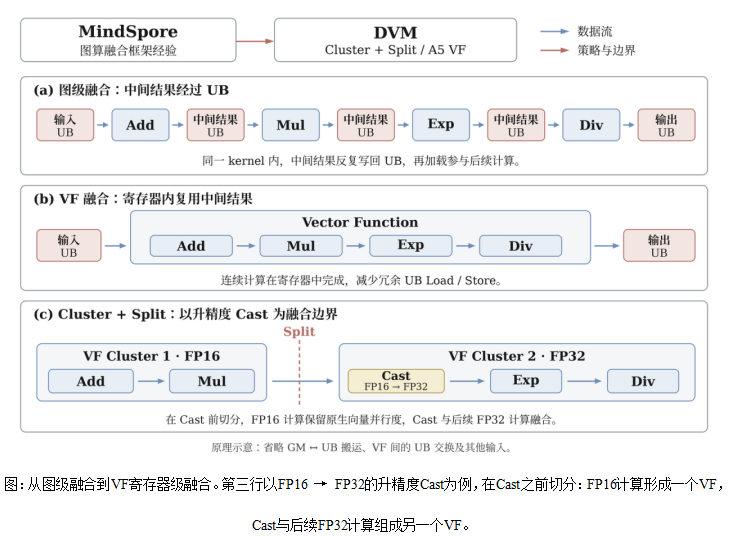
在模型执行过程中,连续的向量计算往往伴随着中间数据的反复搬运。图级算子融合将多个算子合并执行,减少kernel启动和中间结果在全局内存中的读写。昇腾950进一步开放了可编程向量寄存器能力,通过VF(Vector Function,向量函数)组织寄存器级计算。即使多个算子已融合到同一个kernel,计算步骤之间仍可能存在中间结果写回统一缓存UB、再重新加载的过程。VF融合将兼容的计算及其循环合并,让中间结果尽可能在寄存器中被直接消费,减少冗余的搬运、同步和VF调用开销。 DVM借鉴此前昇思MindSpore AKG的经验,采用Cluster + Split策略控制融合pattern与边界。DVM将兼容的计算节点组织为候选cluster,再根据依赖关系、输入输出接口及资源约束确定融合范围,必要时切分为多个适合VF执行的子区域,在减少数据搬运与控制资源开销之间取得平衡。 在实现上,DVM创新性地为简单融合逻辑预先生成对应的VF函数,再通过 aclrtGetFunctionAddr获取函数地址并建立映射,供运行时调用。这使得DVM在获得寄存器级融合收益的同时,避免将VF即时编译开销引入算子编译路径,依旧保持微秒级的算子编译能力。
测试显示,开启VF融合后,SiLU的Vector部分耗时下降55.9%,GELU的Vector部分耗时下降61.7%。 参考链接:https://gitcode.com/mindspore/dvm
——基础框架持续演进——
6 支持 MXFP8 低精算子,大尺寸矩阵计算性能最高提升54%
大模型狂飙突进的背后,正遭遇着海量矩阵计算的效率瓶颈,而低精度计算通过降低位宽与搬运开销,成为了让硬件算力跑满全速的破局关键。昇思MindSpore2.11版本新增MXFP8低精算子能力,覆盖动态量化、量化矩阵乘和分组矩阵乘,为大模型训练中的核心计算模块提供低精支持。MXFP8采用细粒度分块缩放技术,将量化方向上每32个元素划分为一组,以FP8数据配合E8M0缩放因子进行表示。不同数据块使用独立的缩放因子,在降低数据位宽的同时适配各自的数值范围,为高效矩阵计算提供基础。 围绕Dense Linear的计算需求,昇思MindSpore提供单轴与双轴动态量化能力。开发者可在PyNative动态图模式下,将FP16/BF16输入和权重量化为FP8数据,再通过量化矩阵乘完成计算,输出BF16等类型的结果。双轴动态量化还可一次调用生成按行、按列两套量化表示,便于上层训练逻辑针对前向、输入梯度和权重梯度计算选择所需的数据表示,接入不同方向的低精矩阵计算。 面向MoE模型,昇思MindSpore进一步提供分组动态量化与分组矩阵乘能力。针对不同专家接收token数量不均的特点,开发者可依据专家分组信息组织量化与计算,将低精能力应用于专家计算模块,为Dense与MoE架构提供更完整的基础算子支持。 在大尺寸矩阵计算测试中,MXFP8展现出明显的性能优势。固定矩阵维度K、N均为4096,当M分别为2048、8192和16384时,包含输入与权重动态量化开销的MXFP8计算链路,相比BF16路径性能提升约42.6%~53.9%。其中,M为8192时,计算耗时从0.6445 ms降至0.4187 ms,计算速度达到BF16路径的约1.54倍,体现了MXFP8在大矩阵计算场景下的加速价值。 参考链接:https://atomgit.com/mindspore/mindspore