
MindSpore Transformer 动态图全面升级 × MindSpore HyperParallel 分布式引擎:动态图模式下声明式配置多维混合分布式训练
在大模型训练中,随着模型参数规模持续增长,深度学习框架的执行效率与开发体验已成为影响算法迭代周期的关键因素。动态图调试灵活、适配新算法快,静态图则通过编译优化获得更强的运行性能,但二者在实际应用中往往难以兼顾:传统静态图调试困难、灵活性不足,容易成为算法快速迭代的瓶颈;纯动态图虽易于调试,却长期受限于分布式能力薄弱、性能不及静态图的问题。
MindSpore Transformers 推出全新的动态图训练架构:以 TrainConfig 为核心的配置化驱动,叠加 HyperParallel 分布式并行加速引擎,目标是在保持动态图开发体验的同时,获得接近静态图的训练效率。
本文将从设计理念、整体技术栈、多维混合并行能力和上手操作指引等方面,解读这一架构,并说明以配置化为核心的声明式训练体系为何正在成为大模型高性能分布式训练的一种新范式。
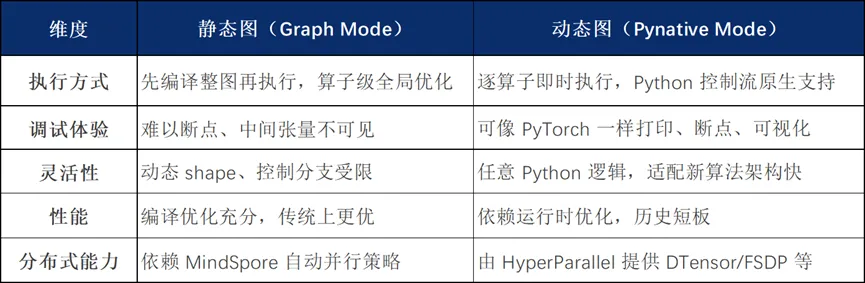
01 动态图 VS 静态图
在进入架构细节之前,有必要先澄清动态图与静态图的本质差异,以及为何 MindSpore 选择在动态图上"战略聚焦"。
02 整体架构
MindSpore Transformers 动态图新架构的设计哲学是 "模型代码与系统优化解耦"。整个系统由三层组成:上层是配置驱动的 Trainer,中层是 HyperParallel 引擎,下层是 MindSpore Pynative 运行时。
text
Pynative Trainer(构建模型/数据集/优化器/Callback)
▲
HyperParallel 引擎(DTensor / HSDP / MPMD / Offload)
▲
MindSpore Pynative Runtime(Ascend NPU)
下图引自 MindSpore Transformers 官方文档,展示了动态图训练栈的整体架构:自顶向下由入口层(run_mindformer.py --mode 1)经总控层(Trainer)路由到动态图训练栈,其中「模型架构」(GPTModel → transformers → layers)、「训练组件」(配置/优化器/损失/回调/工具)与「分布式」(多维并行 + 显存优化)三部分构成核心能力。
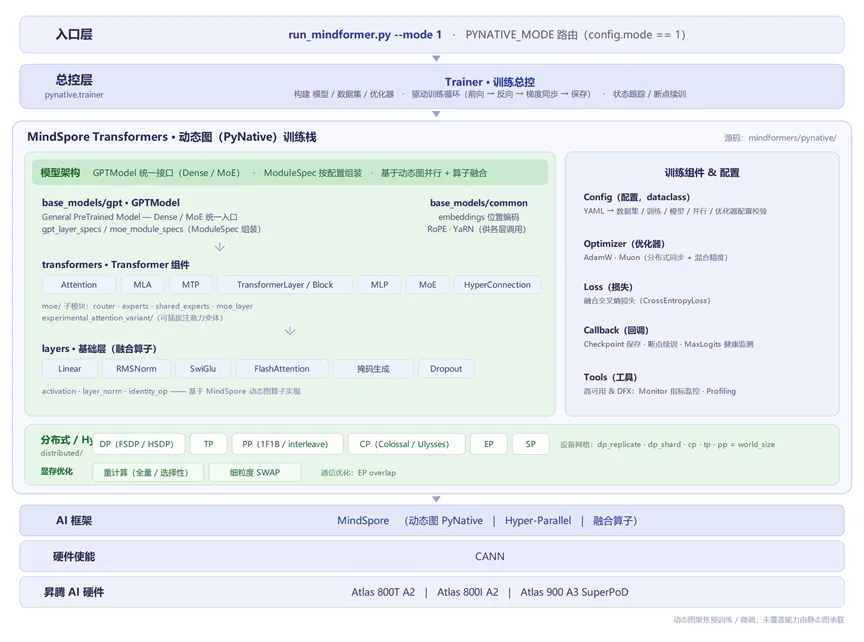
图中 HyperParallel 表示超并行层;DP、TP、PP、CP、EP、SP 分别表示数据并行、张量并行、流水线并行、上下文并行、专家并行和序列并行;FSDP、HSDP 分别表示完全分片数据并行和混合分片数据并行。
2.1 配置化驱动:TrainConfig 统一训练配置
新架构最大的变革在于一切配置皆由 YAML 承载。在mindformers/pynative/config/config.py 中,TrainConfig 这个 dataclass 顶层类聚齐了训练所需的全部子配置:
@dataclass
class TrainConfig(BaseConfig):
  allow_extra = True
  checkpoint: CheckpointConfig      # 检查点保存/加载
  training: TrainingConfig          # 训练步数、batch、grad clip
  parallelism: ParallelismConfig    # TP/EP/CP/PP/SP/FSDP 维度
  optimizer: OptimizerConfig        # AdamW 等优化器
  lr_scheduler: LrSchedulerConfig   # 学习率调度
  train_dataset: TrainDatasetConfig # 数据集与 DataLoader
  model: ModelConfig                 # 模型超参
  monitor: MonitorConfig            # 监控日志
  context: ContextConfig            # MindSpore context
  profiler: ProfilerConfig          # 性能采集
  recompute / recompute_comm        # 梯度重计算
  callbacks                          # 训练回调
这种设计的好处在于:算法工程师只需维护一个 YAML 文件,即可完成从模型结构、并行策略、优化器到数据集的全流程声明,无需在脚本里手写一堆 if-else。所有信息自包含在 YAML 内,避免了配置漂移。
2.2 Trainer:训练流程编排者
mindformers/pynative/trainer/trainer.py 中的 Trainer 类是训练流程的编排者。它本身不实现并行逻辑,而是:
- 从 YAML 加载 TrainConfig;
- 调用 _build_model / _build_dataset / _build_optimizer 等工厂函数;
- 通过 ParallelDims 解析并行维度,构造 DeviceMesh;
- 调用 parallelize_model 把并行策略隐式注入到模型;
- 启动训练循环,借助 CallbackHandler 处理 loss/ckpt/monitor。
入口 run_mindformer.py 通过 --mode 1 调用到 Pynative Trainer,以拉起动态图训练任务:
if config.mode == 1:
   logger.info("Running MindFormers in PYNATIVE_MODE.")
   from mindformers.pynative.trainer import Trainer as PynativeTrainer
   trainer = PynativeTrainer(config.config)
   trainer.train()
   return
2.3 HyperParallel:分布式能力的供给方
HyperParallel 是面向昇腾超节点亲和的分布式并行加速库,它的三大设计思路与新架构的诉求高度契合:
HyperParallel 三大子模块
- HyperShard:编程模型从“系统优化内嵌到模型”演进到“模型和系统优化解耦”。通过 DTensor 统一建模 Tensor 切分、Device 映射、通信路径,实现超节点单卡抽象。
- HyperMPMD:并行范式从 SPMD 演进到集群 MPMD,再演进到芯片内多核 MPMD,支持异构模型分片和多模态流水线。
- HyperOffload:存算关系从 Stateful 演进到 Stateless 计算状态分离,统一编程本地与远端 Tensor,提升集群内存利用率。
这三大方向通过 fully_shard、shard_module、parallelize_module等声明式接口暴露给上层 Trainer,形成“配置化 + 高性能”的关键闭环。
03 多维混合并行
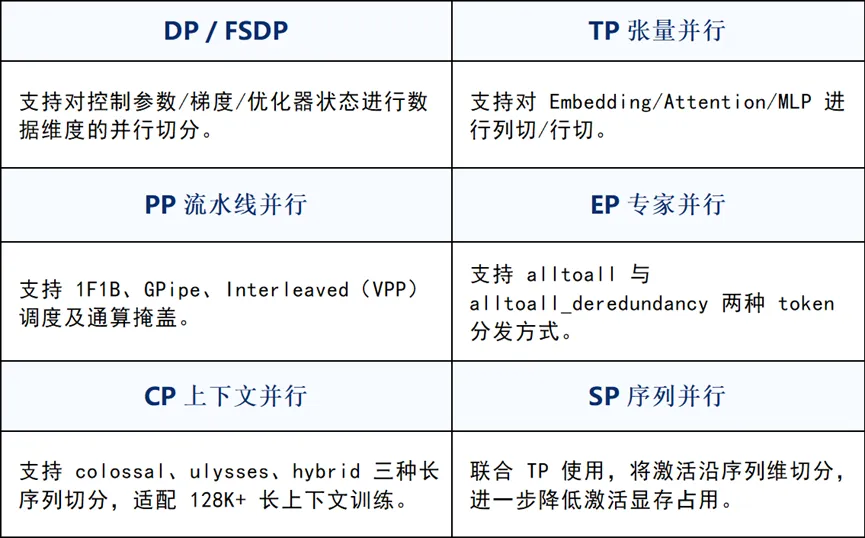
大模型训练的极致性能优化,不能只靠调整单一维度(如DP或TP),而必须进行DP、TP、PP等多维并行的联合调优。HyperParallel 在 Pynative 架构下提供了完整的多维混合并行能力,全部通过 parallelism 段落声明式配置。
3.1 声明式并行的代码示例
以 DeepSeek-V3 预训练为例,配置并行只需在 YAML 中声明,无需侵入模型代码:
parallelism:
 # Data Parallelism & FSDP
 data_parallel_shard: -1
 data_parallel_shard_strategy: "optim_grads_params"
 disable_gradient_division: True
 expert_parallel: 1          # EP size
 tensor_parallel: 1          # TP size
 context_parallel: 1         # CP size
 context_parallel_method: colossal
 pipeline_parallel: 1         # PP stage 数
 pipeline_parallel_schedule: "1f1b"
 pipeline_parallel_microbatch_size: 1
 sequence_parallel: true      # 联合序列并行
 moe_token_dispatcher_type: "alltoall"
提示:当 data_parallel_shard设为 -1 时,系统会根据world_size与其余并行参数自动推导 DP 并行度,免去手动计算的负担。
3.2 parallelize_model:注入而非改写
并行策略如何"落到"模型上?答案是 mindformers/pynative/distributed/parallelize.py中的parallelize_model路由函数。它通过注册机制为每种模型类型分发对应的并行化函数:
def parallelize_model(model, parallel_dims, parallelism,
                       recompute, recompute_comm, swap,
                       gradient_accumulation_steps=1):
    model_cls = type(model)
    if model_cls in _PARALLELIZE_FN:
        return _PARALLELIZE_FN[model_cls](
            model, parallel_dims, parallelism,
            recompute, recompute_comm, swap,
            gradient_accumulation_steps=gradient_accumulation_steps)
    raise ValueError(...)
以 GPT 系(含 DeepSeek-V3、Qwen3)为例,parallelize_gptmodel会按 TP → EP → CP → PP 的顺序逐阶段注入策略。其中 EP 阶段支持把ExpertParallel升级为 OverlapExpertParallel,实现 MoE 通算掩盖,显著提升稀疏专家训练效率。
04 操作指导
本节以 DeepSeek-V3 动态图预训练为示例,演示从环境准备到拉起训练的完整流程。
4.1 环境准备
1.按官方版本配套安装 MindSpore Transformers 运行环境; 2.Pynative 模式依赖 HyperParallel 库提供 DTensor、FSDP/HSDP、Context Parallel 等能力,可参考下例进行安装:
git clone https://gitcode.com/mindspore/hyper-parallel.git
cd hyper-parallel
./build.sh
pip install dist/hyper_parallel-*.whl
构建出的 whl 对运行环境的 glibc 版本有要求:安装环境的 glibc 不得低于构建环境。如需部署到较老系统,请在对应老版本镜像内构建。
4.2 数据准备
Megatron 格式数据集需要.bin 与.idx 文件,数据集可以放置在项目根目录的 datasets 目录下,便于配置文件引用:
mkdir datasets
cd datasets
wget https://atp-modelzoo-wlcb-pai.oss-cn-
wulanchabu.aliyuncs.com/release/models/pai-megatron-patch/deepseek-
datasets/mmap_deepseekv3_datasets_text_document.bin
wget https://atp-modelzoo-wlcb-pai.oss-cn-wulanchabu.aliyuncs.com/release/models/pai-megatron-patch/deepseek-
datasets/mmap_deepseekv3_datasets_text_document.idx
4.3 修改任务配置
以configs/deepseek3/pretrain_deepseek3_1b_8p_pynative.yaml为模板,按需修改以下字段:
1.training:steps、local_batch_size、global_batch_size、max_norm、seed、deterministic; 2.parallelism:根据卡数与显存预算调整 TP/EP/CP/PP/FSDP 维度; 3.train_dataset.dataloader:dataset_files 指向预处理后的数据; 4.context.max_device_memory:Atlas 800T A2 一般 ≤ 60GB,Atlas 800I A2 一般 ≤ 30GB; 5.checkpoint:是否保存、保存路径、是否异步保存。
4.4 启动预训练任务
在 PyNative 模式下通过--mode 1启动run_mindformer.py,以msrun拉起分布式训练。以下示例在 8 卡 Atlas 800T A2(64G)上以 DP=8 启动:
cd $MINDFORMERS_HOME
bash scripts/msrun_launcher.sh "run_mindformer.py \
--config configs/deepseek3/pretrain_deepseek3_1b_8p_pynative.yaml \
--mode 1" \
8 8110 output/msrun_log False 7200
命令执行完毕后训练任务将在后台执行,过程日志保存在./output/msrun_log下,查看训练状态:
tail -f ./output/msrun_log/worker_0.log
训练过程中的权重 checkpoint 将保存在./output/checkpoint下。
4.5 训练 Loss 监控
启动训练后,可通过日志中实时打印的 loss 观察收敛情况。下图为 DeepSeek-V3 1B 动态图预训练的实际 loss 曲线,可以直观预览到模型训练时的收敛效果。
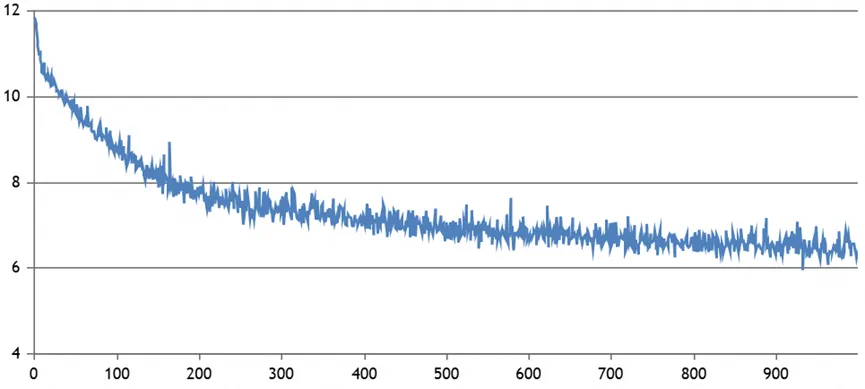
如何导出 loss 曲线:训练日志 ./output/msrun_log/worker_0.log中每步会打印loss值,可用grep "loss=" worker_0.log | awk -F'loss=' '{print $2}'提取后用 matplotlib 绘制;或直接使用 TensorBoard 查看output_dir下的事件文件。
关键约束(来自工程实践)
- Pynative 训练所有配置必须自包含在 YAML;--load_checkpoint、--options 等 CLI 参数被忽略。
- 单卡训练若 model_parallel=1,必须将 sequence_parallel 设为 false,否则会被校验拦截。
- 单卡 DeepSeek3 预训练需用缩小规模模型(如 12 层、8 个 routed experts、seq=2048)以适配显存。
05 结语
MindSpore Transformer 动态图架构的全面升级,配合 HyperParallel 分布式引擎,提供了更易上手、调试及迁移适配的大模型训练能力。
这一架构带来三重价值: 1.对算法工程师:调试体验从黑盒变白盒,新模型结构可以像写 PyTorch 一样快速验证,大幅缩短实验循环。 2.对系统工程师:并行优化通过 DTensor 声明式注入,与模型代码解耦,便于独立演进与长期维护。 3.对算力运营者:HyperParallel 针对昇腾超节点的资源池化、对等架构、FP8 等特性做亲和优化,单卡算力被充分释放。 当下 HyperParallel 已支持 DeepSeek-V3、Qwen3.5-0.8B-Base、Qwen3.5-35B-A3B-Base(MoE)、Qwen3-VL-30B-A3B-Instruct(MoE)等主流模型,并规划了 DeepSeek-V3.2、Qwen3-Omni 等模型的支持路线。在"动静混合"优化、训推一体架构等方向,演进仍在持续。
MindSpore Transformer 始终秉持开源开放的合作理念,持续欢迎开发者提交Issue、贡献代码或分享迁移经验。无论您是企业用户还是个人开发者,都可以通过直接访问官方代码仓参与共建或加入MindSpore Transformer SIG参与交流。
- 参与讨论:加入 MindSpore Transformers SIG 论坛 https://www.mindspore.cn/sig/MindSpore%20Transformers
- 代码共建:在 GitCode 提交 Issue 或 Pull Request https://atomgit.com/mindspore/mindformers