HyperParallel 加速DeepSeek-V4.1多模态1M长序列训练
2026 年 9 月,DeepSeek 发布 DeepSeek-V4.1-Flash。该多模态 MoE 模型拥有 552B 骨干参数,支持最长 1M Tokens 上下文,并引入跨层注意力共享、条件记忆和新型残差连接等设计。
这些创新把训练系统的工作从“切分一个模型”推进到更细的层面:跨层共享状态怎样参与并行与重计算?超大稀疏参数怎样存储和更新?路由、通信与专家计算怎样在昇腾上协同执行?
MindSpore HyperParallel 针对 DeepSeek-V4.1-Flash 的模型结构完成训练适配,结合 FSDP、TP、CP、EP、重计算、异构内存及HyperParallel MegaKernel能力,构建其分布式训练路径。在本文于Atlas 800T A3进行的裁剪模型实验中,叠加MegaKernel 优化后,训练吞吐较全关闭基线提升 26.91%。本文将详细拆解HyperParallel面向DeepSeek-V4.1创新架构的三大技术、训练实践和验证结果。
01 DeepSeek-V4.1 的架构创新与昇腾训练挑战
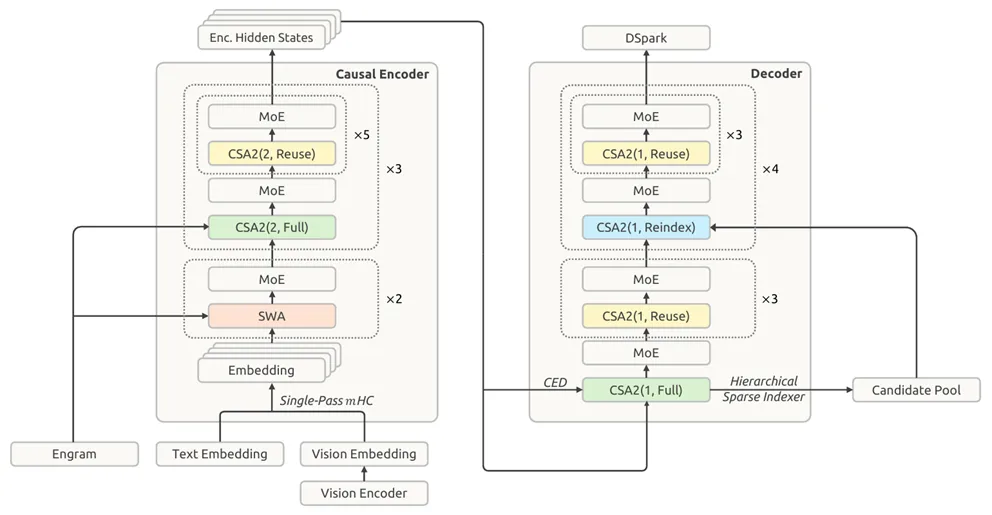
01 Causal Encoder-Decoder(CED)
因果编码器为解码器构建全局 KV,为输入处理与生成安排不同路径。模块之间的依赖也要求训练系统协调数据布局、并行切分与梯度传递,避免各模块独立切分后无法衔接。
02 CSA2
Full 生成 KV 与索引,Reindex 复用 KV 并重选 Top-K,Reuse 同时复用二者,减少跨层重复计算。在昇腾分布式训练中,跨层状态必须在 CP、TP 下保持一致,重计算需复用相同的离散选择,反向梯度则要回传至来源层。
03 Engram
通过 Token N-gram 哈希查表,将记忆向量与隐藏状态融合;两个模块合计约 196B 条件记忆参数,每批仅访问部分行。训练适配需要同时解决大表存储、跨设备查询、稀疏更新及保存恢复,避免稀疏访问承担整表搬运的代价。
04 Single-Pass mHC
维护并混合多路残差流,将残差更新、输入混合与系数计算组织为连续路径。跨子层状态增加了反向和重计算的依赖;细粒度操作还需要适合昇腾的执行组织,减少独立启动与中间数据搬运。
05 原生多模态 MoE
DeepSeek-ViT 将图像转换为语言主干特征,MoE 按 Token 选择专家,并分别维护图文负载均衡。动态路由与图文分布使各专家工作量不等,需要协同组织通信、专家计算与均衡反馈,并衔接视觉与语言主干的并行布局。
06 Head-wise Muon 与 Sinkhorn
前者按注意力 Head 更新部分矩阵,后者通过行列归一化平衡 Engram、Embedding 和预测头等参数的更新尺度。训练系统须协调不同参数组、分片状态与更新方式,保持优化器语义一致。
02 HyperParallel 面向 DeepSeek-V4.1 的昇腾训练适配
HyperParallel 用适配器声明模型依赖与参数所有权,组合并行策略和高性能组件,围绕跨层共享、稀疏记忆与多核执行构建三条适配主线。
2.1 CSA2:支持跨层共享与并行重计算
HyperParallel 按来源层管理 KV、Indexer Key 与 Top-K 等共享条目,使连续状态的梯度回传至生产者,离散选择在重计算时保持一致。
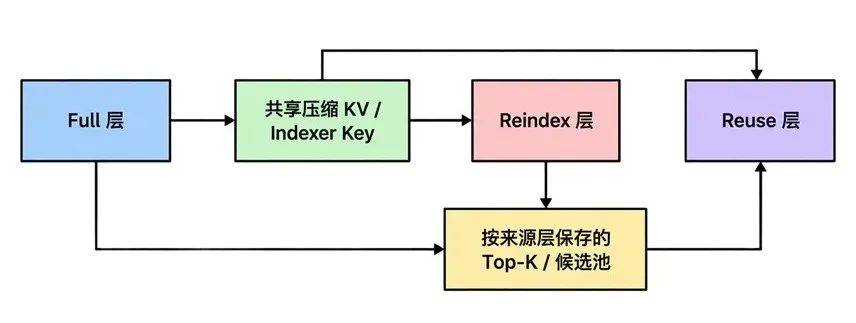
CP 路径通过异步可微 AllGather 汇聚 KV 与 Indexer Key,分离通信发起与等待,以穿插本地投影;TP 先汇总各 Head 分数再选全局 Top-K。重计算按层角色保留或重算激活,复用离散选择、跳过重复发布,状态保留至反向消费者完成。 昇腾端接入 Lightning Indexer、Sparse Flash MLA 前反向及 Indexer KL 梯度,保留 teacher 与标量 KL 语义,并按算子能力、输入形状选择融合或回退路径。 开发者由此可以在保留跨层共享语义的基础上组合 CP、TP 与重计算,为长序列训练分摊激活压力,减少为不同并行组合重复管理共享状态的工作。
2.2 Engram:以稀疏访问支撑大规模条件记忆
HyperParallel 沿 EP 将参数表按行分片,把查询发送给参数所有者,读取后恢复 Token 顺序,反向沿所有权路径回传梯度。
CPU 常驻 Engram 将所属表以 FP32 保存在主机,查询去重后仅搬运命中行,并处理文档边界与图像 Token Mask。反向合并重复行梯度、跨复制维度汇总,参与全局梯度裁剪,由统一入口协调主干优化器和 CPU SparseAdam。
各 owner 的 checkpoint sidecar 保存表与稀疏优化器状态,校验行区间、资产及拓扑后恢复。设备侧存储需求更多地与实际命中行关联,大规模条件记忆得以利用主机内存参与训练;开发者可沿统一路径完成查询、更新和恢复。 主机仍需容纳所属参数与优化器状态。
2.3 MegaKernel: 从逐算子下发到芯片内协同
在逐算子执行路径中,矩阵计算、向量处理与专家通信之间存在多次 Host 下发和阶段等待。Multicore 将相关计算原语组合为融合执行单元,在 Host 侧准备任务切分与依赖关系,由设备侧按计划执行。针对不同模块,既支持矩阵运算核 AIC 与向量运算核 AIV 的协同流水,也支持多个 AIV 对独立 Token 分片并行处理,减少重复下发和等待,让不同类型的计算资源更充分地工作。
- MegaMoE:让通信与专家计算重叠。 将 Token 分发、两次专家矩阵计算、SwiGLU 激活及结果回传纳入融合主链,通过单边通信和分块依赖衔接,推动通信、矩阵计算与向量处理细粒度重叠。结合 push/pull 通信路径与工作区复用,兼顾执行效率和存储开销,并支持 V4.1 所需的 SwiGLU clamp 语义。
- MegaGate:让路由小算子形成流水。 将评分、bias 排名、Top-K、分数提取、归一化与缩放组织为 AIV 路由流水,并融合反向归一化梯度主链,减少路由计算中密集的小算子下发。投影矩阵乘仍沿用 Torch/CANN 的算子选型,支持文本与视觉 Token 使用各自的路由 bias。
- MegaMHC:让残差处理与系数预测协同。 面向 Single-Pass mHC,将残差更新、输入混合、归一化、系数投影与映射按 Token 块组织,使 AIC 上的投影与 AIV 上的输入处理形成重叠流水,并配套反向计算,服务训练过程。
从局部优化到统一训练流程 上述路径由适配器与 YAML 组合,Trainer 统一管理前反向、更新与保存恢复。视觉 Encoder Parallel 采用 Ulysses 布局转换;分块交叉熵避免物化完整词表 logits;Head-wise Muon、Sinkhorn Balancing 与 AdamW 通过参数分组协调分片状态。开发者可在同一训练入口组合这些能力。
03 训练实践:Atlas 800T A3 集群 VLM 训练
在 Atlas 800T A3 集群上开展了全局序列长度为 1M Tokens 的 VLM 训练实验。实验采用裁剪模型与随机初始化权重,保留完整层数和1M最大序列长度,缩减参数维度和路由专家数量,旨在较小集群上尽量贴近完整模型在大集群训练时的单卡平均负载。裁剪规格如下:
| 配置项 | 规模 |
|---|---|
| 语言模型层数 | 保留全部 40 层 |
| 视觉模型层数 | 保留全部 32 个视觉 Block |
| 最大上下文长度 | 保留1M |
| 文本参数维度缩放 | 1/4 |
| 视觉参数维度缩放 | 1/4 |
| Routed Experts | 1/3 |
具体训练配置如下:
| 配置项 | 实验配置 |
|---|---|
| 硬件环境 | Atlas 800T A3,8 nodes 128 dies |
| 软件环境 | CANN 9.2.0-beta.2;Python 3.12;PyTorch 2.12.0;torch-npu 2.12.0;Transformers 5.13.1 |
| 并行配置 | FSDP 128, CP 128, DP 1, TP 1 |
| 启动方式 | 见附录:拉起命令 |
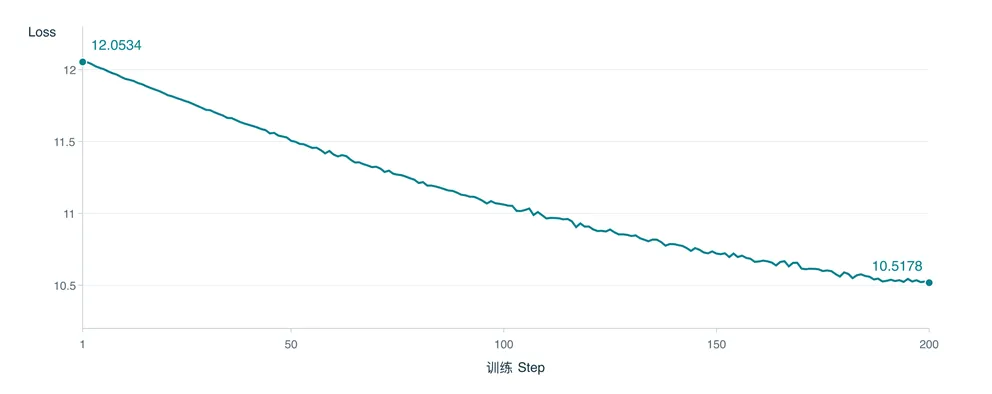
实验完成了200 Step 的连续训练,Loss 从 12.0534 降至 10.5178,Loss 与梯度范数均保持有限值。这组结果验证了 HyperParallel 在该模型配置下,能够协同组织长序列切分、多模态计算与专家并行,完成集群训练的前向、反向及参数更新。
| 训练指标 | 训练结果 |
|---|---|
| Loss 首末值 | 12.0534 → 10.5178 |
| 平均步时(排除首步) | 104.56 s |
| 峰值分配/保留显存( GB) | 34.1870/38.0332 |
在完成训练链路验证的基础上,我们进一步比较了 MegaKernel 的吞吐收益。以 MegaKernel 全关闭为基线,开启 MegaMoe 后吞吐提升 18.34%,三项全部开启后提升 26.91%。其中,MegaMoe 将专家通信与计算纳入统一调度,为多模态 MoE 集群训练提供了直接的性能收益。
| MegaKernel配置 | 吞吐相对基线提升 |
|---|---|
| 全关闭 | 基线 |
| 开启MegaMoe | +18.34% |
| 三项全开启 | +26.91% |
启动命令,上手实践
前面的结果验证了两件事:训练链路能够跑通,MegaKernel 能带来明确的吞吐收益,接下来是亲自上手拉起命令;
# ── 必需的环境(8 个节点都要一致)──────────────────────
source /usr/local/Ascend/cann/set_env.sh
source /usr/local/Ascend/cann-9.2.0/opp/vendors/omni_training_custom_transformer/bin/set_env.bash
export ASCEND_CUSTOM_OPP_PATH="/usr/local/Ascend/cann-9.2.0/opp/vendors/custom_transformer"
export LD_LIBRARY_PATH="/usr/local/Ascend/cann-9.2.0/opp/vendors/custom_transformer/op_api/lib:${LD_LIBRARY_PATH}"
source build/native/payload/hyper_parallel/core/multicore/lib/set_env.bash
export OMP_NUM_THREADS=1
export HCCL_CONNECT_TIMEOUT=600

# ── 每节点差异化的 4 个变量 ──────────────────────────
NODE_RANK=<0..7>              # 节点序号
NODE_ADDR=<本机IP>            # 本节点在 hostfile 里的 IP
MASTER_ADDR=<hostfile 首行 IP>
# NNODES=8 / NPROC_PER_NODE=16 / MASTER_PORT=29500 各节点相同

# ── 训练输入(各节点相同,路径是共享盘)────────────────
MODEL_PATH=/path/to/model
DATA_PATH=/path/to/datasets
CONFIG=examples/training_demo/deepseek_v41/run_deepseek_v41_vlm_1M_online_128die.sh
ASSETS=output/engram_depth_preserving_d4.json
OUTPUT_DIR=output/dsv41_logs_<时间戳>

# ── 唯一的训练启动命令 ────────────────────────────────
cd <hyper-parallel 仓库根目录>
python -m torch.distributed.run \
    --nnodes=8 --nproc_per_node=16 \
    --node_rank=${NODE_RANK} \
    --master_addr=${MASTER_ADDR} --master_port=29500 \
    --local-addr=${NODE_ADDR} --max_restarts=0 \
    --module scripts.train_vl \
    "${CONFIG}" \
    --model.config_path="${MODEL_PATH}" \
    --dataset.model_assets.config_path="${MODEL_PATH}" \
    --dataset.data_path="${DATA_PATH}" \
    --profiler.output_path="${OUTPUT_DIR}/profiler" \
    --memory.save_path="${OUTPUT_DIR}/memory_profiler" \
    --model.engram_assets_path="${ASSETS}" \
04 结语:围绕模型新需求构建训练能力
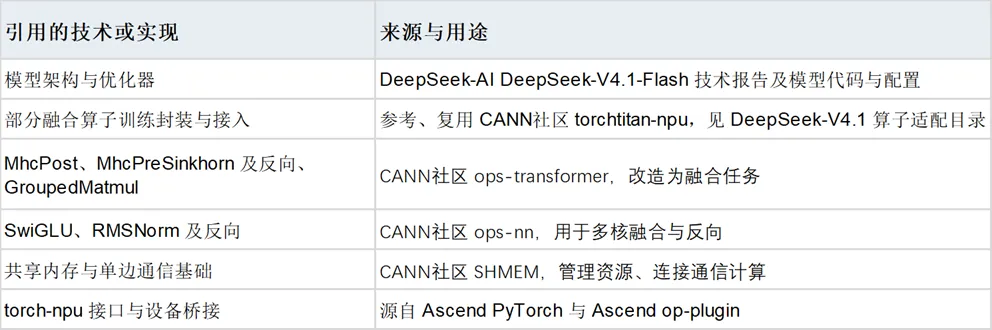
本文涉及的模型设计、基础算子参考/复用DeepSeek、CANN社区及Ascend社区相关开源成果。HyperParallel 在这些开源工作的基础上完成模型适配、共享状态管理、参数分片、任务化改造、多核调度及分布式训练集成。
HyperParallel 将模型新需求转为可组合的并行与多核融合训练能力,持续拓展昇腾大模型训练实践。我们诚挚邀请各位开发者、研究者加入HyperParallel。无论是贡献代码、完善文档,还是提出改进建议,您的参与都将推动大模型分布式并行技术的边界。