昇思 HyperParallel DCP 关键技术拆解:异步持久化、细粒度去冗余、跨切片加载、分片广播
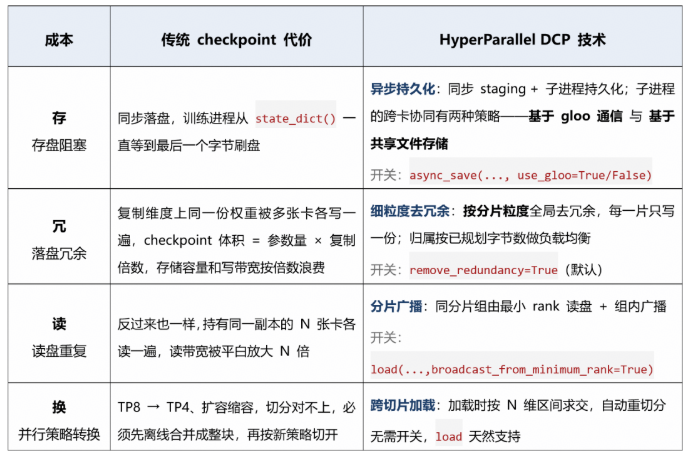
千亿至万亿参数模型训练已进入万卡规模,单次 checkpoint 可达数千 GB,断点续训效率成为长稳训练关键瓶颈。传统 checkpoint 存在四大成本:存盘阻塞、落盘冗余、读盘重复、并行策略转换。
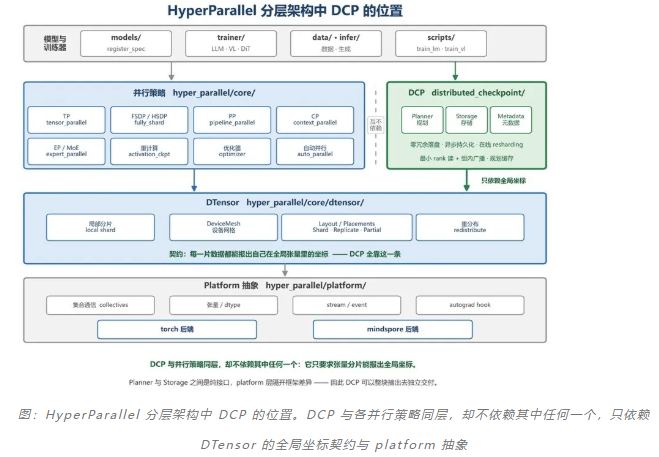
昇思 HyperParallel DCP(Distributed Checkpoint) 将检查点重构为"规划(Planner)—存储(Storage)—元数据(Metadata)"三层解耦架构,构建四大关键技术解决以上四大成本,实现零冗余落盘、零阻塞存盘、零重复读盘、零离线转换。
本文聚焦原理分析,重点阐述四大关键技术。至于接口如何调用、断点续训如何配置等相关操作详见本系列后续实操篇。
01 传统 checkpoint 四大成本
02 HyperParallel DCP 四大技术
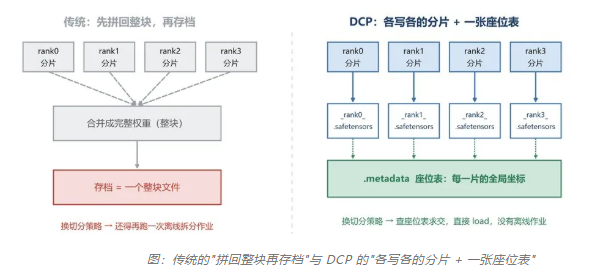
传统方案类似于“先拼回完整图像,再重新切分”:保存时要先把各卡分片合并成完整张量,加载时再按新并行策略重新切分。DCP 每张卡仅保存自身部分分片,并附加一份全局元数据(.metadata,相当于一张“座位表”),记录每个分片在完整张量中的坐标位置,该元数据即全局契约。并行策略变化时,无需恢复完整张量,只需根据新分片区域查询元数据求交。
2.1 异步持久化:同步 staging + 异步落盘
build_staged_state_dict 将权重D2H拷贝到Host,之后构建plan、集群协同、写盘全交给子进程。在 async_save返回后,训练就可以继续执行。
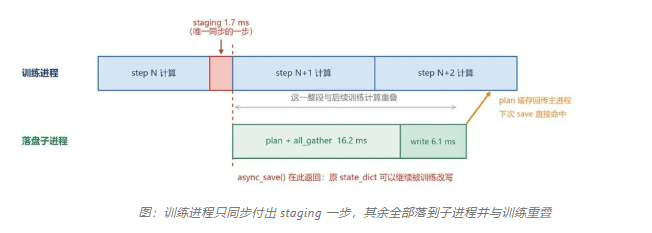
难点在于子进程做集群协同对齐plan,训练侧HCCL/NCCL 通信域活在 C++ 全局状态里,fork 之后就失效了,子进程不能直接复用用。HyperParallel DCP 为此给了两种协同策略,按环境二选一:
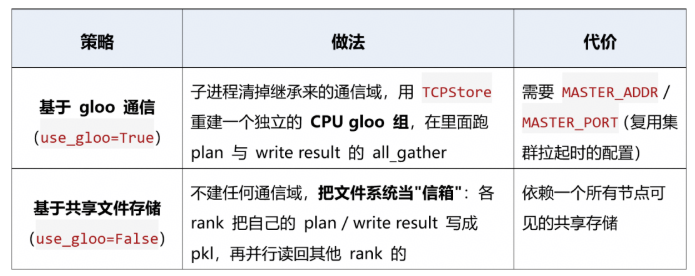
第二种尤其实用:集群本来就有共享文件系统,不必再为 checkpoint 单开一个通信域。在每个 pkl 写完后末尾追加 _COMPLETE_FLAG 标记,读端只认带标记的文件,没有标记就先跳过去读下一个,然后轮询重试,从未保证读到文件都是完整可靠的。
# hyper_parallel/core/distributed_checkpoint/api.py:223
use_gloo=True         → 重建独立的 CPU gloo 通信域
use_gloo=False        → 通过共享文件存储交换 plan 与 write result
use_collectives=False → 降级选项:完全不跨卡,每 rank 各写各的 {rank}.metadata
子进程还会把 plan 缓存带回主进程。规划结果存在 StandardSavePlanner.cached_save_result 这个类级字典里,可算出它的是子进程,子进程一退出,缓存就跟着没了,下一次 async_save 又得从头 all_gather 一遍。DCP 的做法是让子进程写完盘后,把缓存连同 metadata 一起塞回 result queue,由主进程的 join 线程 merge 进自己的缓存:
# hyper_parallel/core/distributed_checkpoint/async_persist.py:389 / 437   子进程侧
result_queue.put((AsyncPersistStatus.SUCCESS, (meta, StandardSavePlanner.cached_save_result)))

# hyper_parallel/core/distributed_checkpoint/async_persist.py:480        主进程的 join 线程
StandardSavePlanner.cached_save_result.update(payload[1])
两条协同策略(gloo / 共享文件存储)都会回传。下一次 async_save fork 出的子进程,继承到的就是这份已经填好的缓存。这意味着同结构的checkpoint 只在第一次做规划,之后每次异步/同步保存都复用缓存。
2.2 细粒度去冗余:分片级去重与负载均衡
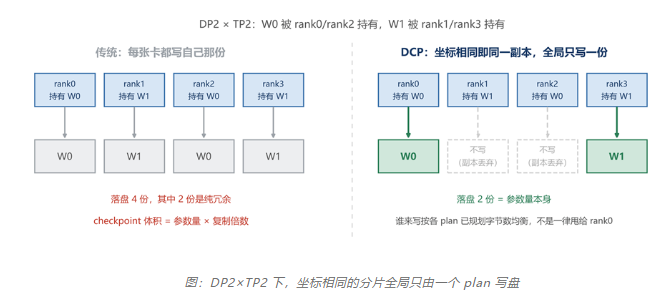
去重的粒度不是"张量"而是分片:MetadataIndex(fqn, offsets) 唯一标识"哪个参数的哪一块",坐标相同的分片按定义就是同一份副本,无论被多少张rank持有,全局只有一个 rank 会写它。DP 复制维度、TP 上的 Replicate()参数、fully_shard 的重叠副本,都只会落盘一份。从而保证checkpoint的体积等于模型参数量本身,而不是参数量 × 复制倍数。
同时去冗余不止是简单丢掉多余副本,它也是一次写侧的负载均衡:
# hyper_parallel/core/distributed_checkpoint/util.py:216
for item_key, containing_plans in multi_plan_items:
    if save_to_minimum_rank:
            target_plan = min(containing_plans)
    else:
         target_plan = min(containing_plans, key=lambda p_idx: storage_sizes[p_idx])
    entry = item_registry[item_key]
    storage_sizes[target_plan] += entry.tensor_storage_size() or 1
    for p_idx in containing_plans - {target_plan}:     # 其余 plan 丢掉这个副本
        remaining_items[p_idx].discard(item_key)
先把"只有一个 rank 持有"的分片入账,再把有副本的分片派给当前写入量最小的那个 rank 。如果一律交给最小号rank,副本都会堆到 DP0 rank上,整体写盘时间就会被这部分卡拖住。
2.3 分片广播:最小 rank 读 + 组内广播
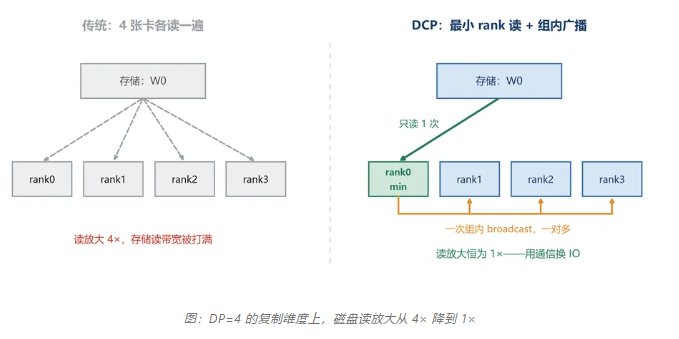
去冗余在读侧有一个对偶操作:
# hyper_parallel/core/distributed_checkpoint/standard_planner.py:492
group_ranks = infer_same_shard_ranks_for_dtensor(tensor)   # 由 mesh_shape + tensor_map 推同分片组
load_rank = min(group_ranks)
if len(group_ranks) > 1:
    setattr(tensor, BROADCAST_INFO, BroadcastInfo(group_ranks, load_rank))
    return self.rank == load_rank
DP=4 的复制维度上,磁盘读量从 4× 降到 1×,由最小号rank从磁盘读,然后广播给组内其他3张rank,用D2D高速通信替换存储IO。
2.4 跨切片加载:N 维区间求交
"拿着新区域去查座位表":每个张量分片都抽象成 N 维半开区间 [start, end),查表即求交,两个区间交集就是要搬运的那片。load时重切分都归结到这里。
# hyper_parallel/core/distributed_checkpoint/reshard.py:88
def infer_intersection(area_a, area_b):
    intersection = []
    for axis_range_a, axis_range_b in zip(area_a, area_b):
        left = max(axis_range_a[0], axis_range_b[0])
        right = min(axis_range_a[1], axis_range_b[1])
        if left >= right:          # 任一维不相交 → 整体不相交
               return None
        intersection.append((left, right))
    return tuple(intersection)
"我要的"与"磁盘上存的"求交,算出的偏移量直接变成读请求:
# hyper_parallel/core/distributed_checkpoint/standard_planner.py:396
overlap = infer_intersection(local_area, saved_area)
if overlap is None:
    continue
dest_offsets    = tuple(overlap[i][0] - local_chunk.offsets[i]   for i in range(len(overlap)))
storage_offsets = tuple(overlap[i][0] - storage_chunk.offsets[i] for i in range(len(overlap)))
lengths         = tuple(overlap[i][1] - overlap[i][0]            for i in range(len(overlap)))
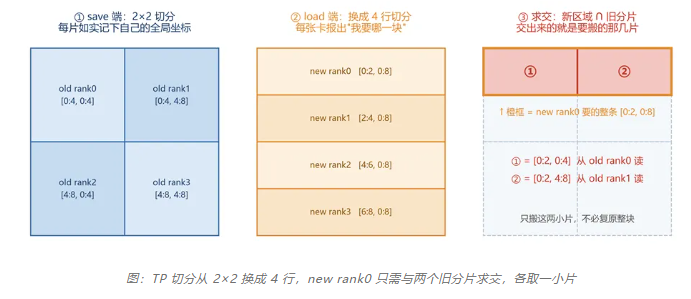
save 端只记录每片全局坐标,load 端只关心"我的新区域压到了哪些旧片"。TP8 存、TP4 读,或者 fully_shard 的分片换一个 mesh,走的都是这套设计逻辑。 除以上四大技术外,HyperParallel DCP还提供 huggingface safetensors ⇄ DCP 离线互转配套工具(offline_transform),用于冷启动加载开源权重、训练结束后导出发布。具体用法见本系列实操篇。
03 万卡集群分钟级恢复
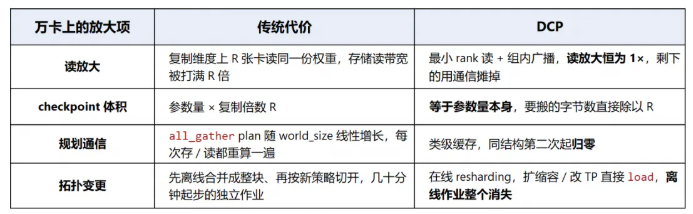
3.1 恢复时间不随卡数线性增长
传统checkpoint 恢复耗时有几项随集群规模和拓扑变更成倍放大,DCP逐个消掉:
3.2 万卡集群实测
在盘古 505B 模型万卡集群训练场景下,实测 HyperParallel DCP:
- 异步保存性能:5s;
- 断点续训状态恢复耗时:290s;
- 当前持续优化中,预计恢复耗时可进一步压缩至 3 分钟内。
04 业界方案对比
这套三层解耦思路业界也有类似方案,PyTorch 的 torch.distributed.checkpoint 、Megatron-LM 的 dist_checkpointing 、字节的 ByteCheckpoint 都基于这条路线构建。
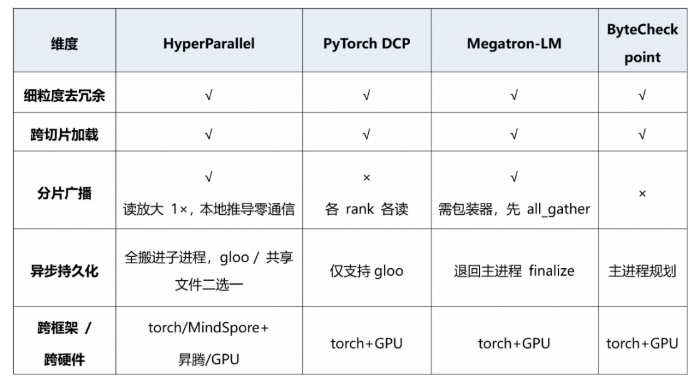
HyperParallel DCP 三项核心竞争力
内置广播能力::
HyperParallel DCP 根据 DTensor本地推导同一分片副本rank,只让其中一张rank读盘,再广播给其余副本。对照之下:PyTorch DCP 未做读侧去重;Megatron 必须先 all_gather 分片元数据才能去重;ByteCheckpoint 也还未实现该能力。
异步落盘整链路搬离主进程:
HyperParallel DCP 把规划、通信、写盘都交给子进程,并提供两种跨卡协同策略:重建CPU gloo 组和共享文件系统通信。大集群本来就有共享存储,选后者就不必为 checkpoint 另开通信域。PyTorch DCP子进程只支持重建CPU gloo;Megatron 子进程只负责写盘,集合通信与 .metadata 落盘退回主进程的 finalize;ByteCheckpoint 则在主进程完成规划。
一份实现覆盖双框架多硬件:
HyperParallel DCP 架构不绑定框架和硬件,torch/MindSpore + NPU/GPU 共用。业界其他架构主要支持torch + GPU。
06 结 语
DCP 是 HyperParallel"故障快速恢复"这条主线的第一块拼图,它先把"存得快、存得省、读得省、切分可变"做扎实。后续故障快恢、临终遗言、SDC 检测等都会基于这套架构构建,只要每片数据全局坐标是可描述的,恢复就是一次区间求交。
DCP 后续规划集中在以下两个关键事项上。
一、极致性能
存侧性能已近乎极致,读侧还有优化空间。其一是读侧负载均衡:同一分片有多个副本 rank 时,"谁去读"可以按rank读取量来均衡;其二是读取和广播异步流水化:读完的分片立刻广播,与后面分片的读盘重叠。这两步做完,恢复耗时还能再压一个台阶。
二、独立交付:
DCP 是一个相对独立模块,不与 HyperParallel 并行实现绑定,只依赖"张量分片报出自己全局坐标"这一个约定。因此,上层不管是 HyperParallel 还是其他基于torch生态构建的加速方案,都可以接入HyperParallel DCP,享受关键技术优势。
07 欢迎加入 HyperParallel
我们诚挚邀请各位开发者、研究者加入HyperParallel。无论是贡献代码、完善文档,还是提出改进建议,您的参与都将推动大模型分布式并行技术的边界。让我们一起,让大模型训练更简单、更快速、更智能!