
昇思MindSpore社区 2026 年 9 月份运作报告
一、概述
2026年9月,昇思MindSpore开源社区持续深耕技术突破与生态共建,在社区治理、社区活动、技术分享等方面取得多项重要成果。
在技术分享方面,MindSpore HyperParallel完成DeepSeek-V4.1-Flash核心训练路径适配,在Atlas 800T A3、16 die上完成轻量化多模态100步验证,稳态单步4.96s、全局吞吐约13212 tokens/s;一站式使能HuggingFace模型高性能多维并行,以声明式配置实现FSDP、TP、CP、EP及Production/Validation双模式DTensor;DCP关键技术拆解,以“规划—存储—元数据”三层解耦实现零冗余落盘、零阻塞存盘、零重复读盘、零离线转换,盘古505B万卡集群异步保存5s、断点续训恢复290s。
在社区活动方面,MindSpore HyperParallel亮相PyTorch Conference China 2026,Qwen3-30B-A3B训练吞吐较PyTorch-FSDP2+Muon提升超200%;量子学术奖励基金优秀成果奖励名单公布,10个项目获奖,覆盖量子处理器、VQE、分子优化等方向。昇思正携手开发者与生态伙伴,共筑全场景AI开源创新生态。
以下是2026年9月份昇思MindSpore社区进展详细报告。
二、社区运作
截至9月底,昇思MindSpore 开源社区稳健运营、生态持续扩容,始终坚守开放协作、技术普惠、共建共治的核心原则,聚焦 AI 框架技术迭代、生态协同与开发者生态建设,社区组织架构高效运转、技术贡献与活跃度双提升,筑牢 AI 开源生态的坚实底座,推动全场景 AI 框架技术与产业应用深度融合。
- 社区单位会员达 356 家,累计贡献者5.5万+;
- 社区累计产生ISSUE共95.5K、PR共134.1K。
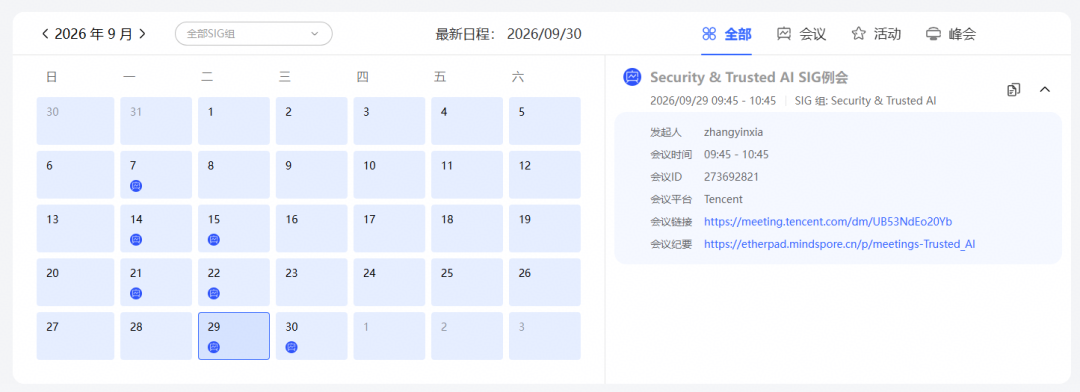
9月份社区治理体系高效运转,开源发展委员会、技术委员会常态化推进决策与技术统筹,各 SIG 小组协同发力,技术贡献与社区活跃度稳步攀升。
- 9月提交issue 213个,合入PR 641个;
- 新增代码行数超 59万行,SIG 专项会议累计召开 4场。
三、社区活动
01 HyperParallel亮相PTC 2026:专为超节点打造的分布式并行组件
9月9日,PyTorch Conference China 2026在上海举行。华为AI框架首席技术专家苏腾介绍专为超节点打造的分布式并行组件HyperParallel,并由Linux基金会Jonathan Bryce现场启动Live Demo。
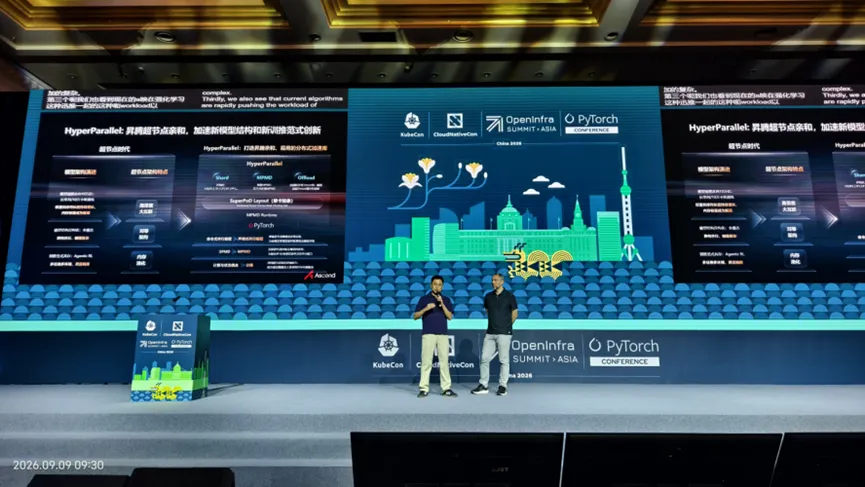
在昇腾Atlas 800 A3风冷超节点上,HyperParallel+PyTorch训练Qwen3-30B-A3B,相同配置下较PyTorch-FSDP2+Muon训练吞吐提升超200%,且loss收敛一致。其依托昇腾亲和module与FSDP2零拷贝通信,兼容HuggingFace、LlamaFactory等生态。Ascend for PyTorch社区已汇聚超1000名贡献者,外部贡献超50%。未来HyperParallel将持续优化多模态、长序列、高稀疏MoE,并回馈PyTorch等开源社区。
02 学术奖励基金优秀成果奖励名单公布
近日,中国物理学会-量子科技长三角产业创新中心-MindSpore Quantum学术奖励基金优秀成果奖励名单公布。基金2025年1月启动,确定30个资助项目,截至2026年3月27个完成验收。
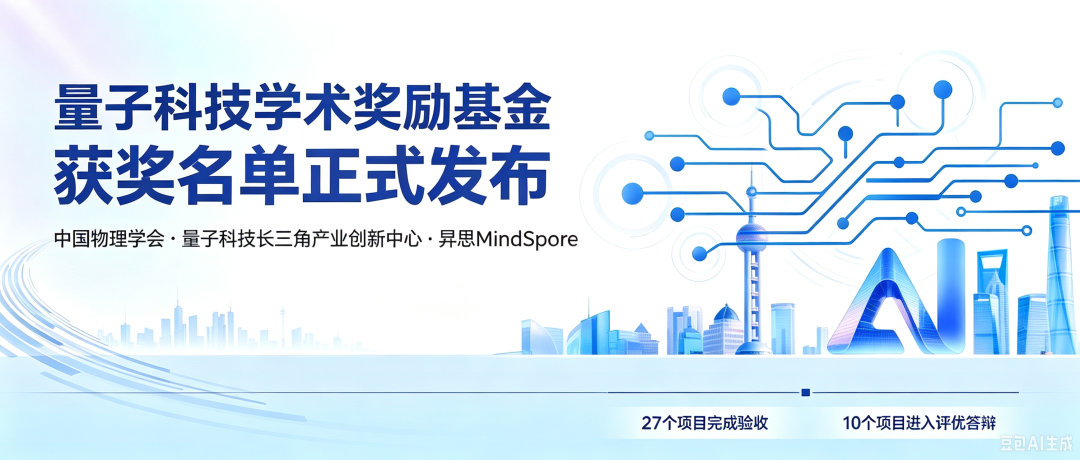
经6月答辩入围、8月技术管理委员会评审,最终10个项目获奖,含A+类1项、A类4项、B类5项。获奖者来自浙江大学、中科院软件所、北京大学、中山大学、北京理工大学等,成果覆盖量子处理器、VQE、分子优化、分布式量子算法、拓扑相变检测等方向,并配套开源代码,持续推动开源量子计算软件应用与原创科研。
四、技术分享
01 MindSpore HyperParallel一键开箱DeepSeek-V4.1-Flash
9月10日,DeepSeek发布多模态MoE模型DeepSeek-V4.1-Flash。MindSpore HyperParallel基于Hugging Face同步完成核心训练路径适配,通过Model Adapter接入FSDP、TP、CP、EP等并行能力,复用Trainer、数据组件及Muon+AdamW优化器,覆盖DeepSeek-ViT、Engram、CSA2、mHC和图文路由。
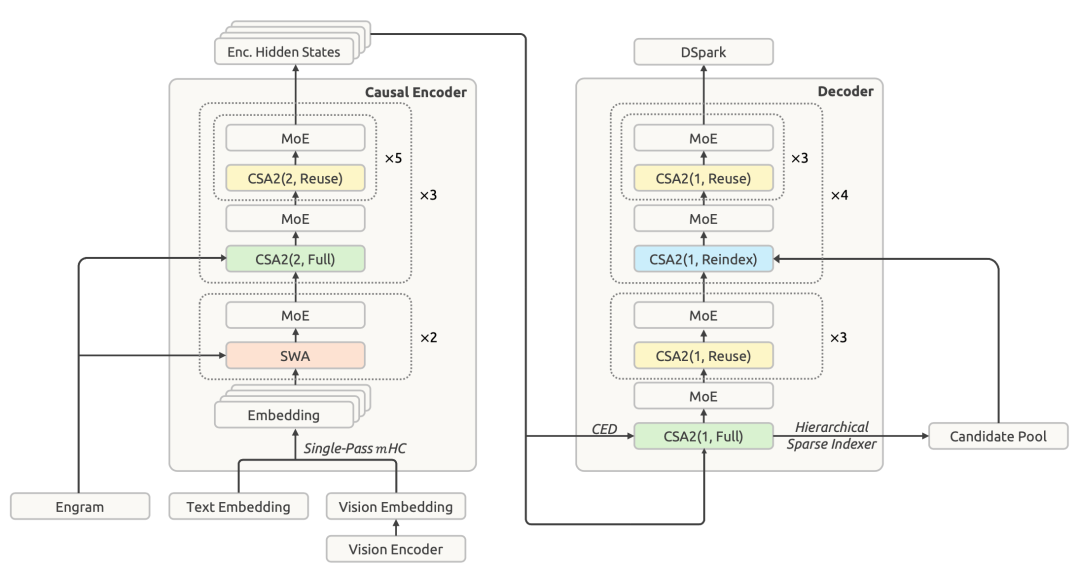
在Atlas 800T A3、16 die完成轻量化多模态训练100步验证,稳态单步4.96s,全局吞吐约13212 tokens/s,loss与grad norm稳定;并完成TP2+SP、CP2单步验证。后续将推进完整规模模型适配验证。
02 MindSpore HyperParallel一站式使能HuggingFace模型高性能多维并行
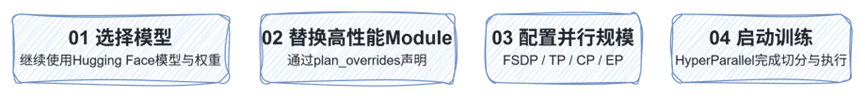
9月,在PyTorch Conference China 2026上,MindSpore HyperParallel分享其整体设计与实践。HyperParallel在保留HuggingFace模型生态和使用习惯基础上,通过声明式配置实现高性能多维并行:直接复用HuggingFace模型结构、Config和预训练权重;按需声明式替换Attention、Norm、MoE等高性能模块;通过配置定义FSDP、TP、CP、EP并行拓扑,自动生成Sharding Plan;并提供Production/Validation双模式DTensor,兼顾运行性能与并行正确性验证。该方案让分布式训练从“模型主动适配”转向“围绕模型声明配置”,降低大模型高性能分布式训练适配成本。
03 昇思 HyperParallel DCP 关键技术拆解:异步持久化、细粒度去冗余、跨切片加载、分片广播
昇思HyperParallel DCP关键技术拆解,针对万卡规模下checkpoint存盘阻塞、落盘冗余、读盘重复、并行策略转换四大成本,DCP采用“规划—存储—元数据”三层解耦架构,实现异步持久化、分片级细粒度去冗余、最小rank读+组内广播、跨切片N维区间求交加载,达成零冗余落盘、零阻塞存盘、零重复读盘、零离线转换。
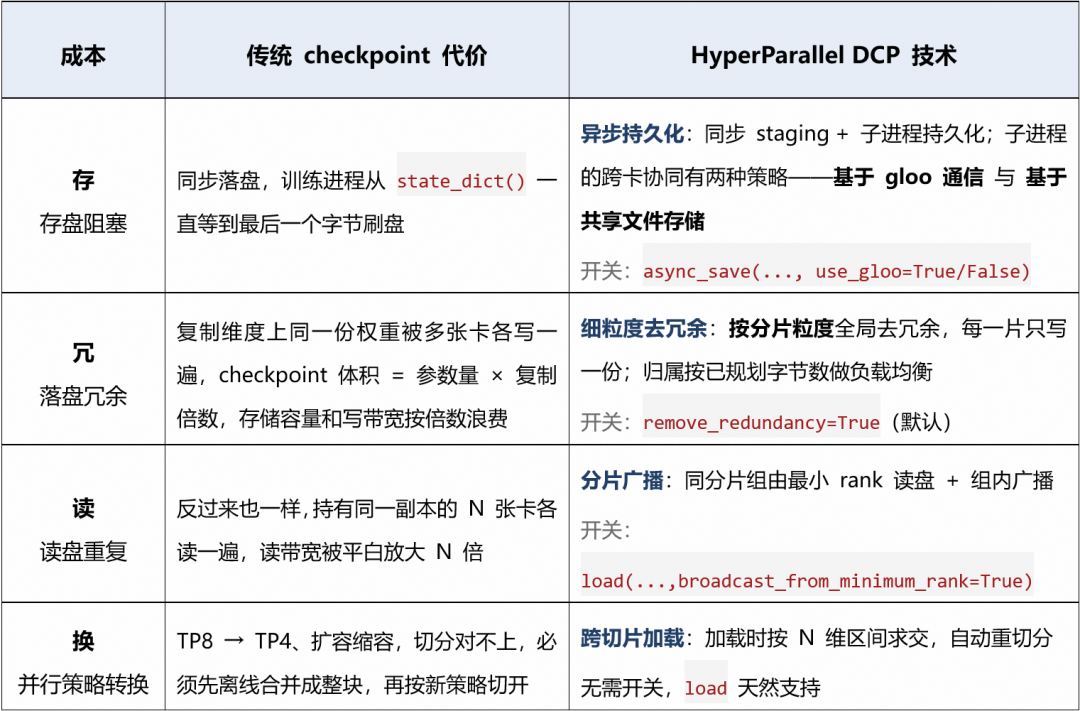
盘古505B万卡集群实测:异步保存5s,断点续训恢复290s,预计压缩至3分钟内。其内置广播、异步落盘整链路搬离主进程、一份实现覆盖torch/MindSpore与NPU/GPU三项能力突出。后续将优化读侧负载均衡与异步流水化,并独立交付支持更多生态接入。
五、感谢每一位朋友、开发者的支持
在此感谢社区伙伴们、可爱的小孢子们以及昇思MindSpore SIG组成员们,因为大家的共同努力及辛勤奉献,昇思MindSpore才能不断成长与发展!同时我们对可能出现的不完善之处向您表示诚挚的歉意,并衷心感谢您的理解与支持。🌸🌸
未来,昇思MindSpore AI框架将持续致力于打造人工智能创新之源,凝聚产业力量,扎根AI根技术,使能大模型与科学智能,成为AI创新的首选框架。