
MindSpore HyperParallel一站式使能HuggingFace模型高性能多维并行
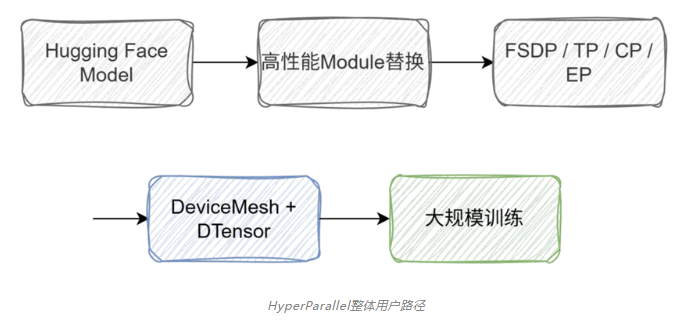
HuggingFace凭借丰富的模型生态和统一的接口,让开发者能够更方便地获取和使用各类大模型。但在大规模训练场景下,如何进一步提升训练性能、使能FSDP、TP、CP、EP等多维并行能力,仍然需要开发者进行额外适配。 HyperParallel希望解决的正是这一问题:在保留HuggingFace模型生态和使用习惯的基础上,通过声明式配置实现性能优化和多维并行能力,降低模型走向高性能分布式训练的适配成本。
在近日举办的PyTorch Conference China 2026上,我们也围绕HyperParallel的整体设计与实践进行了分享,重点介绍了其在HuggingFace模型兼容、高性能模块替换以及多维并行等方面的最新进展。
01 HuggingFace模型原生适配
传统高性能分布式训练方案中,新模型往往需要重新实现高性能模块,再处理参数映射、权重加载和并行逻辑等适配工作。模型一旦升级,适配成本也随之增加。
HyperParallel采用另一条路径:直接复用HuggingFace模型结构、Config和预训练权重,并在模型构建过程中注入系统优化能力。
以当前官方示例为例,用户仍然通过HuggingFace模型路径加载模型:
model:
  _target_: hyper_parallel.models.HyperAutoModelForCausalLM.from_pretrained
  pretrained_model_name_or_path: /path/to/Qwen3-30B-A3B
  torch_dtype: bfloat16
  force_hf: true
用户不需要为了实现大规模分布式训练,重新维护一套模型。HuggingFace继续负责模型生态,HyperParallel负责系统优化。
02 高性能模块声明式替换
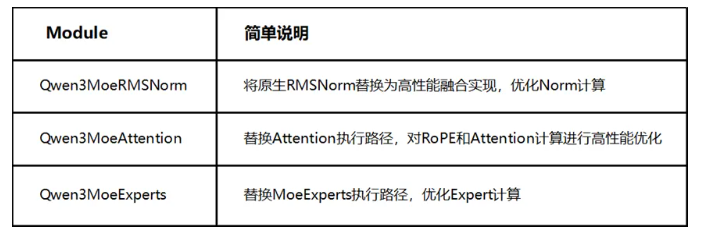
通用实现不一定是目标硬件上的最优实现。针对Attention、Norm、MoE等关键计算模块,HyperParallel支持在保留原有HuggingFace模型结构的基础上,按需替换为高性能实现。
用户无需修改模型源码,只需要通过 plan_overrides 描述匹配哪个Module,以及替换成什么实现:
plan_overrides:
 - match: "*.self_attn"
   module_type: transformers.models.qwen3_moe.modeling_qwen3_moe.Qwen3MoeAttention
   replace_module:
     _target_: hyper_parallel.models.qwen3_moe.adapter.replacements.replace_qwen3_moe_flash_attention
以Qwen3-30B-A3B为例,当前示例包含以下高性能模块替换:
03 多维并行能力声明式配置
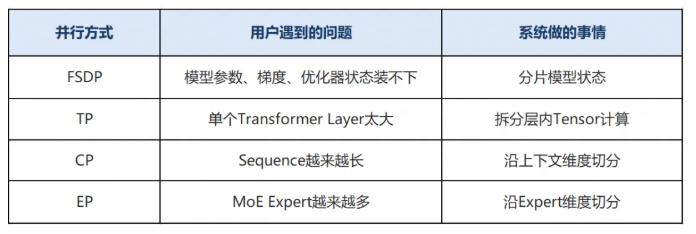
完成模型接入和高性能模块替换后,接下来需要考虑的是如何将模型合理切分到更多设备上,实现高效的大规模训练。FSDP、TP、CP、EP分别对应四类最常见的训练瓶颈。
fsdp_config:
dp_shard_size: 2
edp_shard_size: 2
reshard_after_forward: true
reshard_after_backward: true
forward_prefetch_depth: 1
backward_prefetch_depth: 1
以上为8卡多维并行配置示例,通过TP=2、CP=2、EP=2结合FSDP完成模型切分。

# 04 双模式DTensor:兼顾性能与正确性验证

声明式并行越自动,正确性越重要。Shard维度选错、Module边界Layout不匹配、Redistribute遗漏,都可能让多卡语义与原始模型产生偏差,而且不一定马上报错。

但真实训练又不希望每一步都承担额外的DTensor Dispatch和动态Layout推导开销。HyperParallel因此将这两个目标拆成Production和Validation两种模式。

<div style="text-align: center;">

<img src="/category/information/technology-blogs/banner/2026-9-18/5.jpg" style="display: block;margin: 0 auto;max-width:60%" alt="" >

</div>
真正关键的不是“有两个模式”,而是验证路径不能成为另一套实现。两种模式共享同一份Sharding Plan。对于CP Attention、MoE Token Dispatch等这类需要显式通信的场景,Production和Validation也会尽量复用相同的执行逻辑,保证验证结果能够真实反映生产环境。

Production降低DTensor动态调度带来的运行时开销,Validation用于验证并行策略及分布式布局的正确性。

# 05 统一配置驱动高性能分布式训练

<div style="text-align: center;">

<img src="/category/information/technology-blogs/banner/2026-9-18/6.jpg" style="display: block;margin: 0 auto;max-width:60%" alt="" >

</div>

过去散落在模型代码、并行代码和硬件优化代码里的工作,被重新组织成几个更简单的问题:

1.模型从哪里来?—— HuggingFace生态
2.模型怎么跑得更快?—— High Performance Module
3.模型怎么切?—— FSDP / TP / CP / EP
4.怎么兼顾性能和正确性?—— Production / Validation

HyperParallel想做的,不只是增加几个分布式API。

它更希望让高性能分布式训练,从“模型必须主动适配”逐渐变成“围绕模型声明配置”。从“为了分布式训练重新实现模型”,走向“保留一份HuggingFace模型,声明它应该如何高效运行”。

# 06 快速上手:一键体验多维并行

HyperParallel提供examples/training_demo用于快速体验FSDP、TP、CP、EP等多维并行能力。Qwen3-30B-A3B完整模型建议在满足模型显存和并行配置要求的集群环境下运行;如果暂时缺少相应集群资源,也可以通过裁剪模型层数等配置,在单机8卡环境下快速跑通多维并行训练流程:
Offline数据模式
bash examples/training_demo/run_parallel_offline.sh \
/path/to/Qwen3-30B-A3B
Online数据模式
bash examples/training_demo/run_parallel_online.sh \
/path/to/Qwen3-30B-A3B
还可以直接开启DTensor Placement Validation:
bash examples/training_demo/run_parallel_offline.sh \
/path/to/Qwen3-30B-A3B \
--model.validate_placement=true
完整示例可参考:

https://github.com/mindspore-ai/hyper-parallel/tree/master/examples/training_demo

# 07 欢迎加入 MindSpore HyperParallel

我们诚挚邀请各位开发者、研究者加入HyperParallel。无论是贡献代码、完善文档,还是提出改进建议,您的参与都将推动大模型分布式并行技术的边界。让我们一起,让大模型训练更简单、更快速、更智能!

<div style="text-align: center;">

<img src="/category/information/technology-blogs/banner/2026-9-18/7.jpg" style="display: block;margin: 0 auto;max-width:60%" alt="" >

</div>
无论是代码实现、文档完善、示例补充还是Bug反馈,您的每一份贡献都将帮助更多研究者和开发者受益。