
MindSpore HyperParallel一键开箱DeepSeek-V4.1-Flash
9月10日,DeepSeek正式发布DeepSeek-V4.1-Flash。新模型采用全新的Causal Encoder-Decoder架构,在模型能力、推理速度和吞吐量等方面进一步提升,并具备原生多模态视觉理解能力。 MindSpore HyperParallel基于Hugging Face同步完成DeepSeek-V4.1-Flash核心训练路径适配,实现快速适配。
01 模型介绍
DeepSeek-V4.1-Flash是DeepSeek最新发布的多模态MoE模型,拥有552B Backbone参数和196B Engram参数,支持最长1M tokens的上下文,并原生支持图像和文本输入。每个MoE层配置1个Shared Expert和384个Routed Experts,每个Token激活6个Routed Experts。
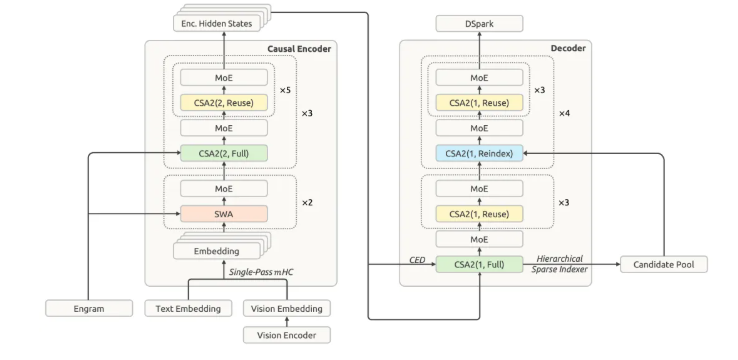
模型采用全新的Causal Encoder-Decoder架构,Language Backbone共40层,由20层Causal Encoder和20层Decoder组成。Prefill阶段每个Token激活8B参数,Decode阶段每个Token激活16B参数,在保持大模型容量的同时降低计算成本。
02 DeepSeek-V4.1-Flash快速适配
HyperParallel基于DeepSeek官方开源模型(https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash),通过Model Adapter接入FSDP、TP、CP和EP等多维并行能力,并复用通用Trainer、数据处理组件及Muon + AdamW优化器链路,完成DeepSeek-V4.1-Flash核心训练路径适配。
HyperParallel通过声明式Model Adapter定义模型适配规则,由Sharding Planner结合模型结构与并行配置生成切分方案,使新模型能够复用已有并行训练能力,减少重复开发,支撑快速适配。
本次适配主要包括:
接入DeepSeek-ViT、3×3 pixel-unshuffle、两层Aligner与图文路由对应的多模态训练链路;
为Single-Pass mHC的跨子层状态传递、Engram分布式查表以及CSA2的Full / Reindex / Reuse模式补充并行适配;
通过声明式并行计划组织TP、CP、EP与FSDP,打通Online多模态数据处理、模型前向、反向传播及优化器更新流程。
03 快速开始
HyperParallel提供DeepSeek-V4.1-Flash轻量化训练验证样例。完成HyperParallel环境安装并准备好模型配置、Tokenizer和多模态数据后,即可启动训练。
3.1 获取并安装适配代码
DeepSeek-V4.1-Flash适配样例当前位于deepseek-v4.1-preview分支。克隆该分支并安装HyperParallel:
git clone -b deepseek-v4.1-preview https://gitcode.com/mindspore/hyper-parallel.git
cd hyper-parallel
pip install -e .
3.2 准备模型配置
从DeepSeek Hugging Face官方仓库(https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash)获取config.json、tokenizer.json和tokenizer_config.json,并将MODEL_PATH设置为文件所在目录。该验证样例采用随机初始化的模型权重,无需下载完整模型权重。
MODEL_PATH=/path/to/DeepSeek-V4.1-Flash
3.3 准备多模态数据
训练数据采用OpenAI Messages格式的JSONL文件,图像通过image_url指定。将DATA_PATH设置为训练数据文件路径,并确保其中引用的图像可访问。
DATA_PATH=/path/to/deepseek_v41_messages/train.jsonl
3.4 确认训练配置
样例默认使用16个die,序列长度为4K。发布版配置与本次轻量化验证配置对比如下:
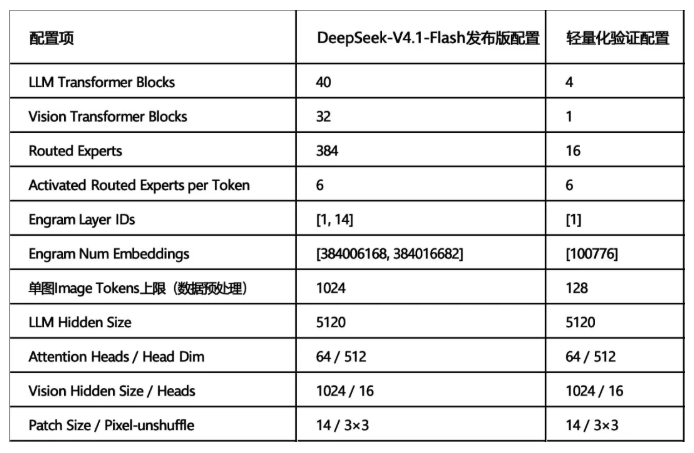
启动进程数应与设备网格及TP、CP、EP、FSDP等并行配置相匹配;调整并行策略时,应同步检查启动参数与对应配置。
3.5 启动训练
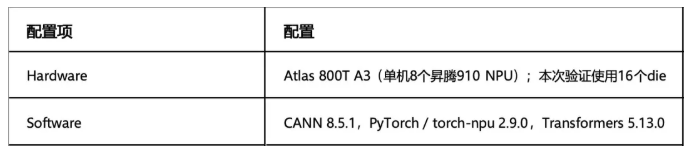
本样例基于以下环境完成验证:
04 HyperParallel训练性能实测
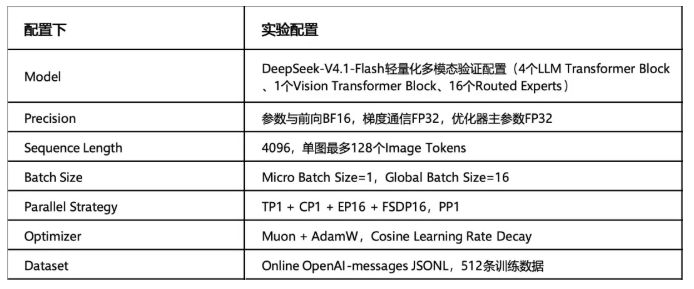
HyperParallel基于Atlas 800T A3,在16个die上完成了DeepSeek-V4.1-Flash轻量化多模态模型连续100 Step的训练验证,覆盖DeepSeek-ViT、3×3 pixel-unshuffle、两层Aligner、Single-Pass mHC、Engram、CSA2、图文路由以及Online数据处理链路。
实验配置
训练性能
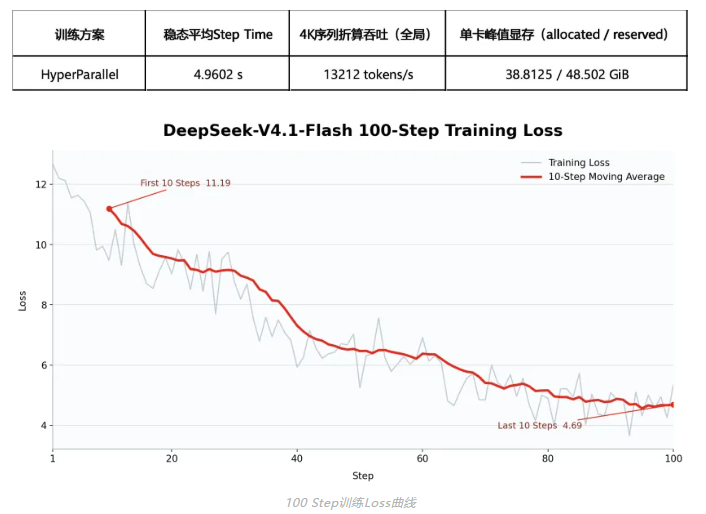
在TP1 + CP1 + EP16 + FSDP16并行策略下,训练连续完成100 Step,loss和grad norm均未出现NaN或Inf。稳态平均单步耗时为4.9602 s,按全局Batch Size 16、序列长度4096折算的全局吞吐约为13212 tokens/s;100 Step纯训练总耗时为504.47 s。
多维并行能力
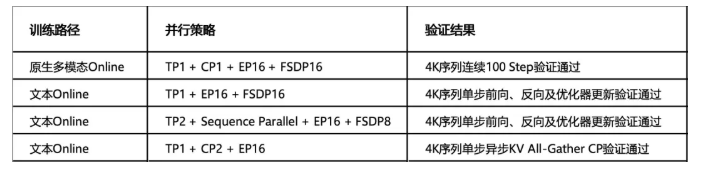
05 总 结
HyperParallel通过Model Adapter、高性能组件和多维并行能力,完成DeepSeek-V4.1-Flash核心训练路径适配,并在Atlas 800T A3上使用16个die完成轻量化模型训练验证。
下一步,HyperParallel将推进DeepSeek-V4.1-Flash完整规模模型的训练适配与验证,并持续跟进前沿模型架构与训练技术,进一步优化训练性能、显存效率和大规模扩展能力。

无论是代码实现、文档完善、示例补充还是Bug反馈,您的每一份贡献都将帮助更多研究者和开发者受益。